Signal 01
40 %
Tâches manuelles automatisées
1 h économisée chaque matin
Chez Hoist Finance, l'automatisation de 40 % des tâches manuelles a fait gagner une heure chaque matin à plusieurs dizaines de collaborateurs.
Disponible immédiatement
Mickaël Rakotoarinivo
+5 ans à concevoir, industrialiser et exploiter des plateformes data pour la finance, la logistique et les équipes analytiques.
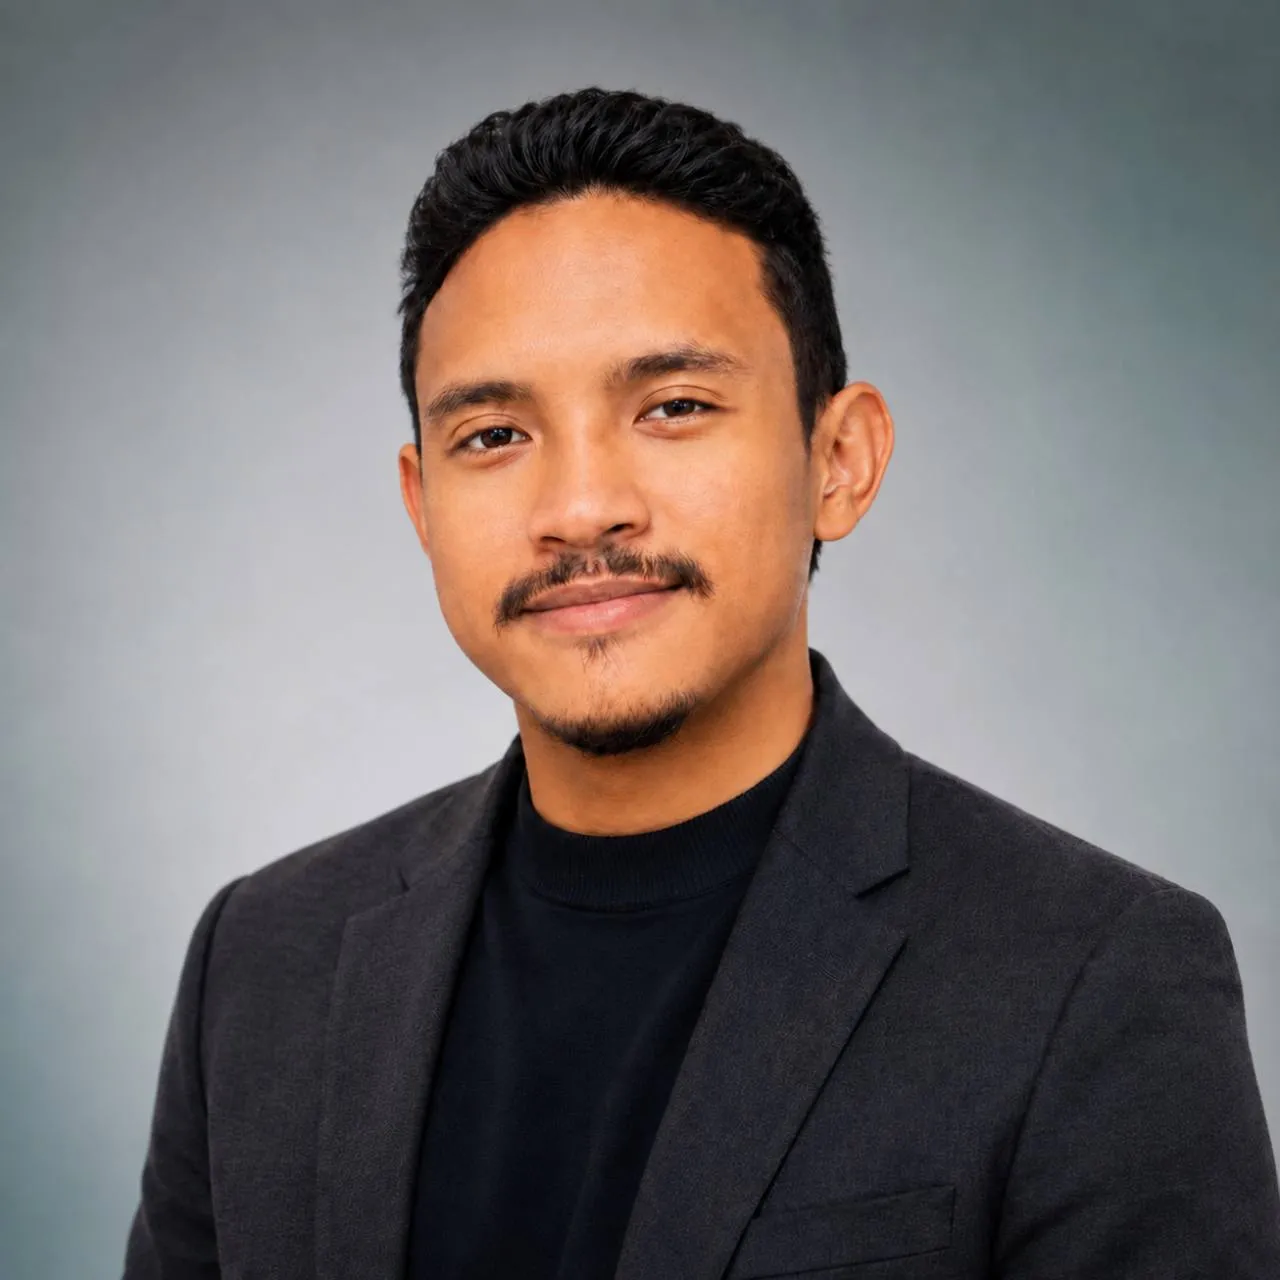
Je modélise les données, teste les transformations, surveille les traitements et documente les flux pour que les équipes métier puissent utiliser les données.
Je travaille sur des pipelines batch et streaming, des architectures en médaillons et des modèles en étoile ou en flocon. En production, je traite les incidents, optimise les performances et assure l'astreinte et le support. Je partage les bonnes pratiques avec les équipes.
Chez Hoist Finance et InPost
Signal 01
1 h économisée chaque matin
Chez Hoist Finance, l'automatisation de 40 % des tâches manuelles a fait gagner une heure chaque matin à plusieurs dizaines de collaborateurs.
Signal 02
Chez Mondial Relay / InPost, j'ai conçu plus de 20 rapports pour les équipes des opérations, de la relation client et de Damage & Loss. Une trentaine de personnes les utilisaient.
Signal 03
Chez Mondial Relay / InPost, j'ai modélisé et optimisé certains traitements Spark SQL / PySpark. Leur temps de calcul est passé d'environ 2 h à 20 min, soit une réduction d'environ 83 %.
API SA, mission chez tl
J'ai modernisé les données financières et BI des tl dans Snowflake, avec des pipelines ELT en SQL et Python, des modèles dimensionnels, des tests et un framework d'exécution inspiré de dbt. Chaque jour, ces traitements convertissaient une dizaine de procédures stockées brutes en tables Silver pour la direction financière et le contrôle de gestion.
Mondial Relay by InPost Group
Pipelines batch et streaming sur Azure Databricks et Delta Lake. Unity Catalog, CDF, Auto CDC, Kafka, SCD, snapshots et GitLab CI/CD dans un contexte international.
Hoist Finance
J'ai automatisé des extractions et des contrôles qualité, planifié des pipelines ETL, puis produit des rapports opérationnels et des analyses statistiques dans le secteur bancaire.
Une application d'optimisation de paniers qui collecte les prix fournisseurs, normalise les produits et répartit les lignes selon les offres disponibles.
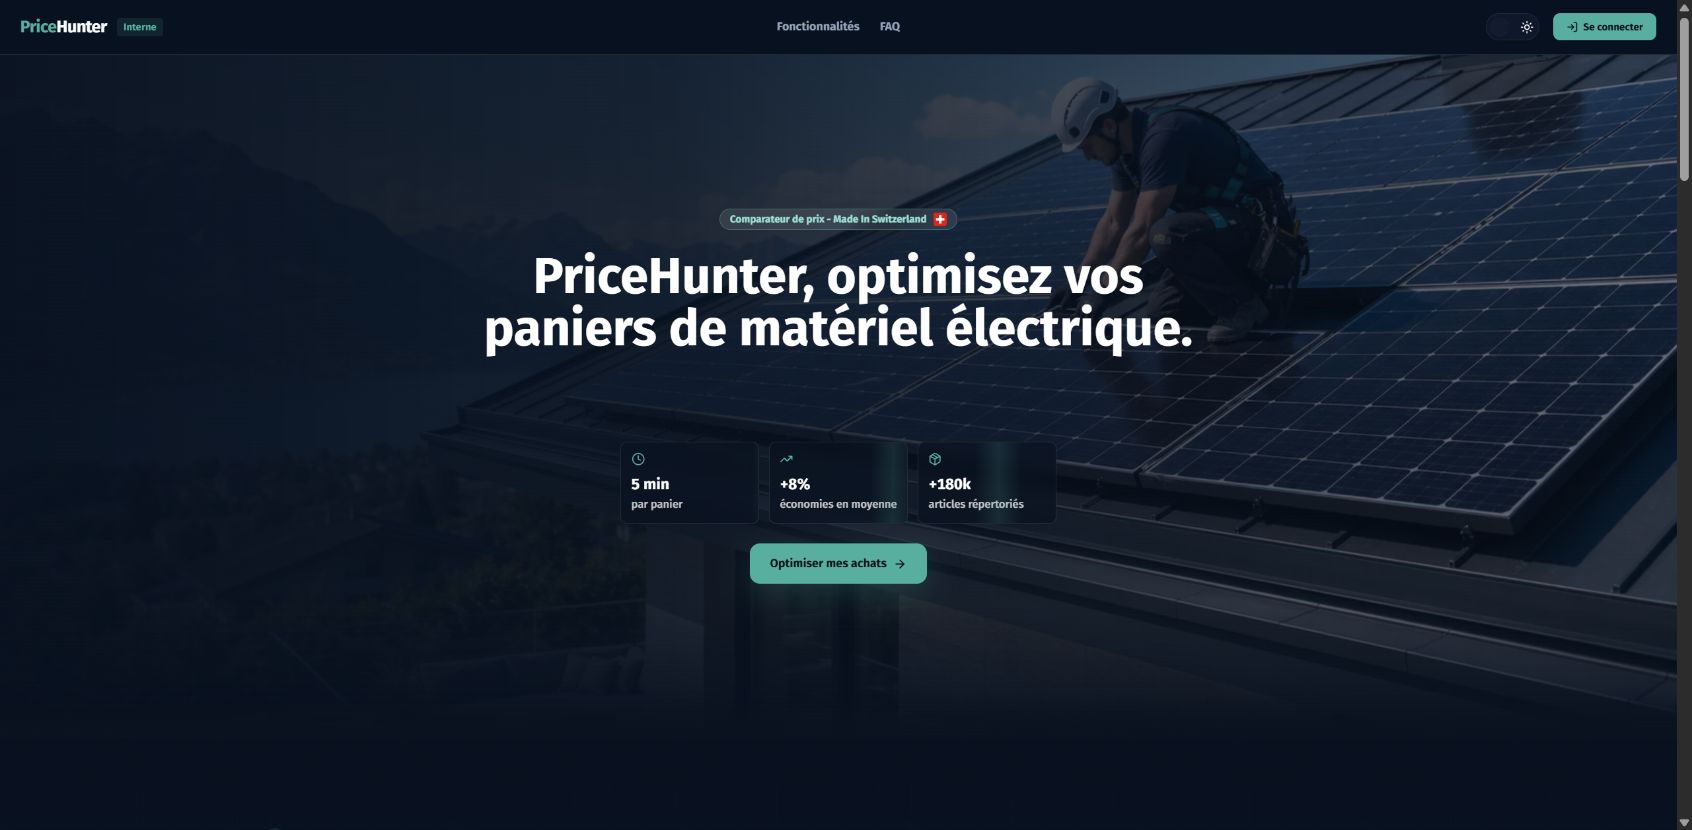 Aperçu statique Ouvrir le site
L'aperçu n'est pas disponible pour le moment.
Ouvrir le siteUn atelier SQL pour explorer des fichiers CSV, JSON, Parquet et Excel dans le navigateur, avec DuckDB WebAssembly. Les fichiers restent sur l'appareil.
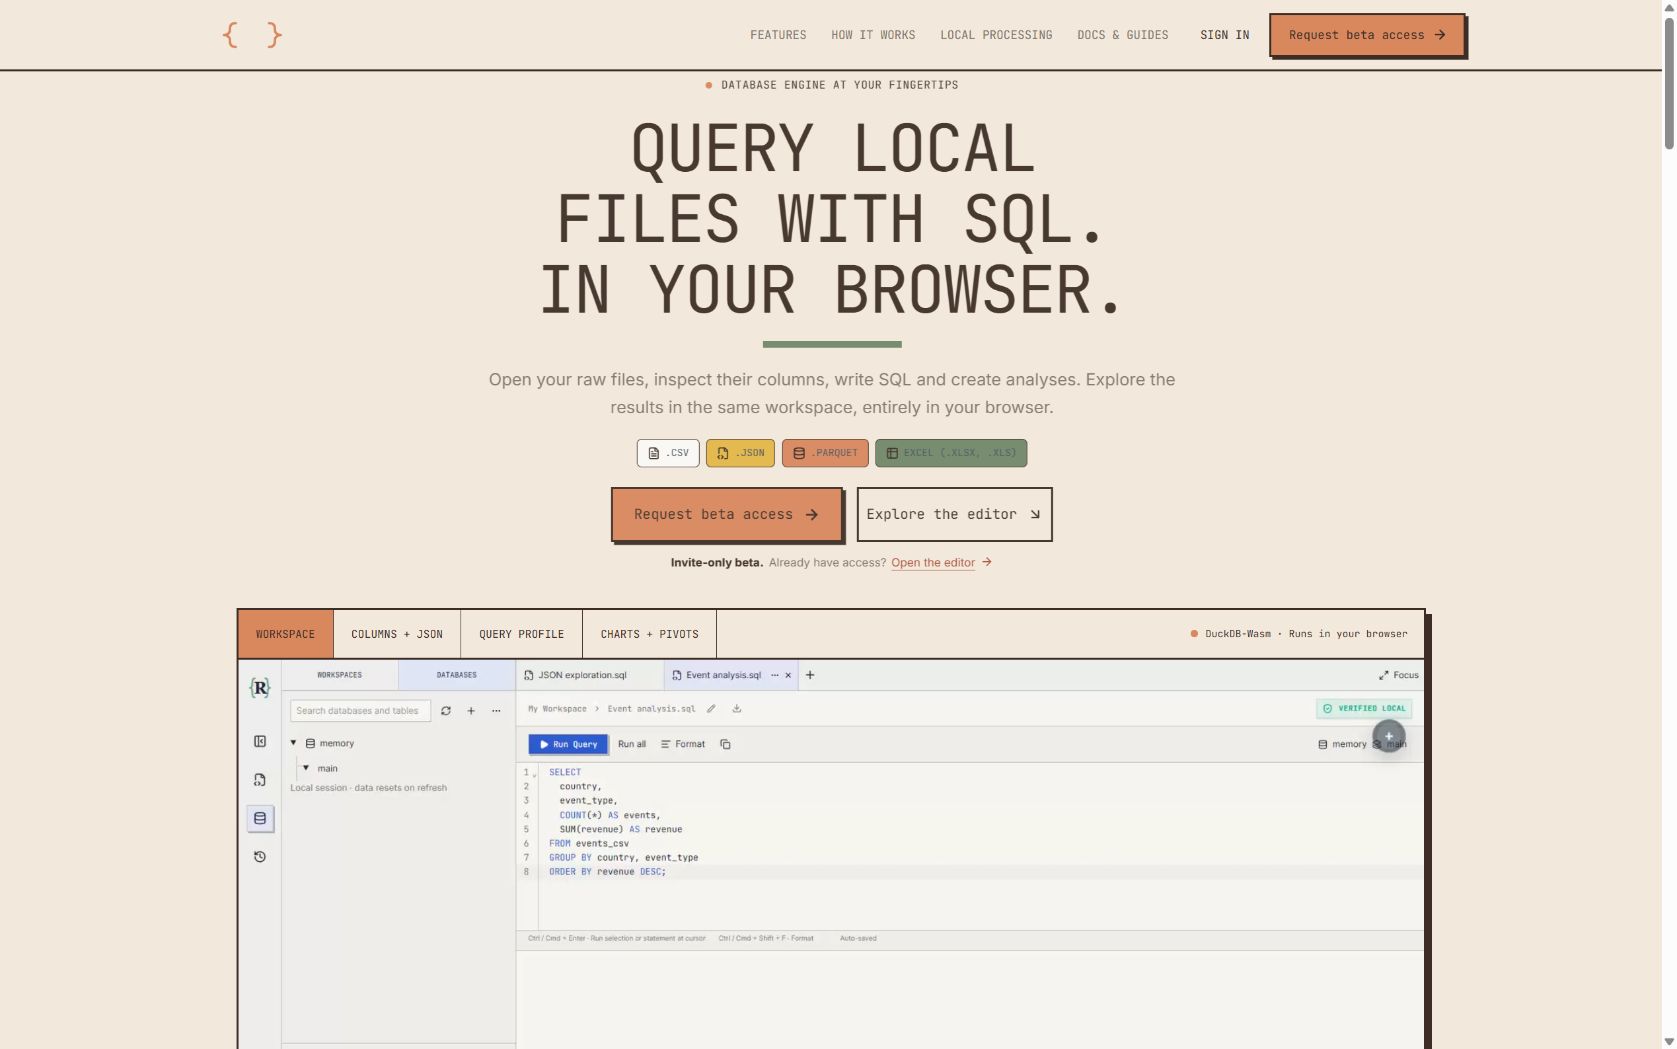 Aperçu statique Ouvrir le site
L'aperçu n'est pas disponible pour le moment.
Ouvrir le siteUn pipeline Python et PostgreSQL alimente des transformations dbt et un dashboard Next.js mis à jour chaque jour avec des données du marché Bitcoin.
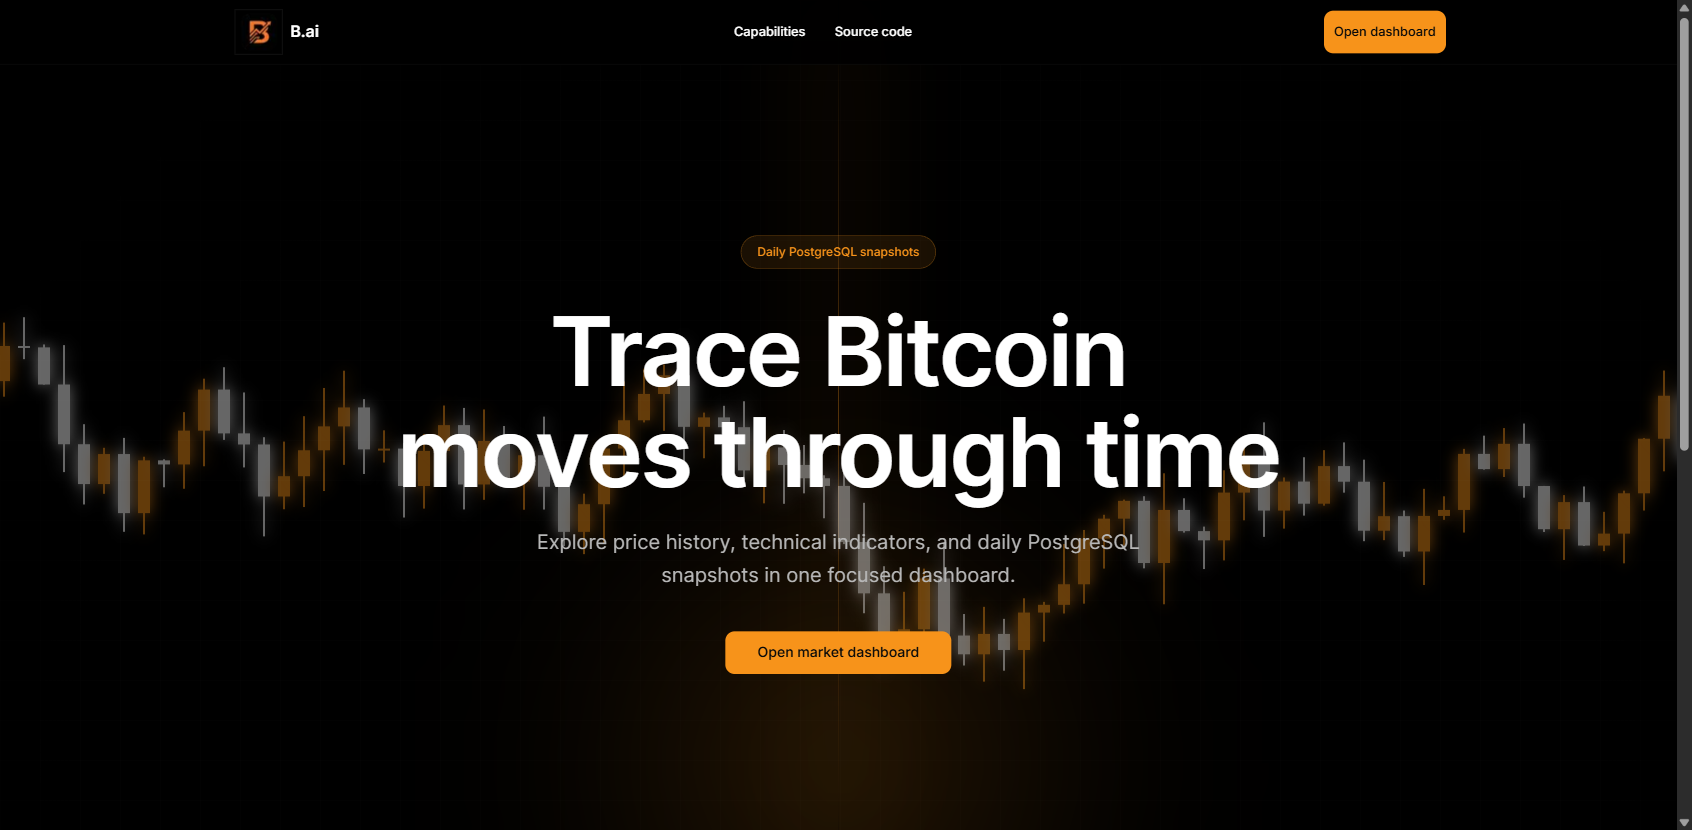 Aperçu statique Ouvrir le site
L'aperçu n'est pas disponible pour le moment.
Ouvrir le siteOuvert aux opportunités en Suisse romande